R квадрат в регрессии — это метрика, которая показывает, какую долю изменений целевой переменной модель может объяснить на основе имеющихся факторов. Для аналитиков, руководителей функций и команд, принимающих решения на основе данных, это один из самых часто используемых индикаторов качества регрессионной модели. Но на практике именно его чаще всего трактуют слишком упрощённо: высокий R² принимают за доказательство сильной модели, а низкий — за повод сразу её отклонить. Такой подход опасен. Если вы оцениваете прогноз продаж, спроса, затрат, производительности или клиентских показателей, важно понимать не только что показывает R-квадрат, но и где он перестаёт быть надёжным ориентиром.
Все дашборды в этой статье построены с помощью FineBI
R квадрат в регрессии: что это и что именно он показывает
Если говорить просто, R² показывает, насколько хорошо модель описывает наблюдаемые данные. Он отвечает на вопрос: какую часть разброса целевой переменной удалось объяснить с помощью признаков модели.
Например, если вы прогнозируете выручку по рекламным расходам, сезонности и числу лидов, то R-квадрат показывает, насколько изменения выручки согласуются с этими факторами в рамках построенной модели.
Простое определение без сложной математики
Представьте, что у вас есть набор значений: продажи по филиалам, расход топлива, стоимость заказа или время выполнения операции. Эти значения колеблются — то есть имеют разброс. Регрессионная модель пытается описать этот разброс через закономерность.
R-квадрат в регрессии показывает, какую долю этого разброса модель смогла “поймать”, а какая часть осталась необъяснённой.
Почему этот показатель связывают с качеством модели
R² удобен, потому что даёт быстрый и понятный сигнал:
- значение ближе к 1 означает, что модель хорошо описывает данные;
- значение ближе к 0 означает, что объясняющая сила модели низкая;
- в некоторых случаях R² может быть даже ниже 0, если модель предсказывает хуже, чем простое среднее.
Именно поэтому R-квадрат часто используют как первый фильтр качества. Но это только часть картины, а не окончательный вердикт.
Что означает значение ближе к 0 и ближе к 1
Интерпретация обычно выглядит так:
- R² = 0,85 — модель объясняет около 85% вариации целевой переменной;
- R² = 0,40 — объясняется примерно 40% разброса;
- R² = 0,05 — связь слабая, большая часть изменений остаётся вне модели.
Однако важно учитывать контекст:
- в инженерных и физических задачах высокий R² часто ожидаем;
- в маркетинге, экономике, поведении клиентов и социальных данных даже умеренный R² может быть полезным;
- для прогноза на новых данных важна не только “красота” подгонки, но и устойчивость модели.
Key Metrics (KPIs) для оценки регрессионной модели
Ниже — ключевые показатели, которые стоит смотреть вместе с R²:
- R-квадрат (R²) — доля вариации целевой переменной, объяснённой моделью.
- Скорректированный R² — версия R² с поправкой на число признаков; помогает не переоценивать модель при добавлении лишних переменных.
- RMSE — корень из средней квадратичной ошибки; показывает типичный масштаб ошибки с усиленным штрафом за крупные промахи.
- MAE — средняя абсолютная ошибка; удобна для бизнес-интерпретации в тех же единицах, что и целевая переменная.
- Ошибка на тестовой выборке — проверка, как модель работает на данных, которых не видела при обучении.
- Анализ остатков — показывает, есть ли систематические ошибки, нелинейность или проблемы со структурой модели.
- Стабильность по сегментам — помогает понять, одинаково ли модель работает по регионам, продуктам, каналам или периодам.
Как считается R-квадрат
Базовая идея через долю объяснённой вариации
На интуитивном уровне всё сводится к одному вопросу: сколько общего разброса данных модель смогла объяснить.
Если бы у нас вообще не было модели, самым простым прогнозом было бы среднее значение целевой переменной. Тогда ошибка была бы довольно большой. Если же модель учитывает факторы и даёт более точные предсказания, ошибка уменьшается. R² как раз сравнивает эти две ситуации.
Идея такая:
- есть общий разброс целевой переменной;
- есть необъяснённый разброс, который остаётся после работы модели;
- чем меньше необъяснённая часть, тем выше R-квадрат.
Формула без перегрузки деталями
Стандартная формула выглядит так:
R² = 1 - (сумма квадратов ошибок модели / общий разброс данных)
Иными словами:
- если ошибки модели маленькие, дробь мала, а R² высок;
- если ошибки почти такие же, как у наивного прогноза по среднему, R² будет близок к нулю;
- если модель совсем неудачна, значение может стать отрицательным.
Из каких частей складывается расчёт:
- общий разброс целевой переменной — насколько фактические значения отличаются от среднего;
- ошибка модели — насколько предсказания отклоняются от реальных значений.
Связь простая: чем сильнее модель сокращает ошибку по сравнению с “прогнозом средним”, тем выше её R².
Короткий пример расчёта
Допустим, компания анализирует ежемесячные продажи и строит регрессию по числу обращений, скидкам и сезонности.
Пусть:
- общий разброс продаж равен 100;
- после построения модели сумма квадратов ошибок составила 25.
Тогда:
R² = 1 - 25/100 = 0,75
Это означает, что модель объясняет 75% вариации продаж.
Что важно увидеть в этом примере:
- R² не говорит, что прогноз “точен на 75%”.
- Он не показывает среднюю ошибку в рублях, штуках или процентах.
- Он лишь показывает, насколько модель лучше объясняет разброс данных по сравнению с очень простой базой — средним значением.
Как интерпретировать R-квадрат на практике
Что значит высокий R-квадрат
Высокий R² — это хороший знак, но не автоматическое доказательство того, что модель полезна для бизнеса.
Когда высокий R-квадрат действительно говорит в пользу модели:
- данные имеют устойчивую закономерность;
- признаки действительно связаны с целевой переменной;
- качество сохраняется на тестовой выборке;
- остатки не показывают систематических искажений.
Но даже очень высокий R² ещё не гарантирует качественный прогноз. Модель может идеально описывать прошлое и при этом плохо работать на новых данных. Особенно часто это происходит при переобучении.
Что значит низкий R-квадрат
Низкий R² не всегда означает плохую модель.
В каких ситуациях это нормально:
- данные шумные и зависят от множества неучтённых факторов;
- поведение объекта нестабильно и быстро меняется;
- задача связана с человеческим поведением, рынком, спросом, рекламным откликом;
- модель строится не для полного объяснения, а для выделения отдельных значимых факторов.
Например, в маркетинговой аналитике модель с умеренным или даже низким R² может быть полезной, если она стабильно показывает направление влияния факторов и помогает принимать решения лучше, чем интуиция.
Можно ли сравнивать модели по R-квадрат
Да, но только при правильных условиях.
Сравнение уместно, если:
- модели решают одну и ту же задачу;
- используется одна и та же целевая переменная;
- сравнение идёт на одинаковых данных;
- модели оцениваются не только по обучающей, но и по тестовой выборке.
Сравнение может вводить в заблуждение, если:
- число признаков сильно отличается;
- одна модель переобучена;
- сравниваются модели для разных сегментов или разных горизонтов прогноза;
- игнорируются RMSE, MAE и поведение остатков.
Когда R-квадрат вводит в заблуждение
Высокое значение при плохой модели
Это один из самых опасных сценариев в аналитике. Модель может показать высокий R², но быть практически бесполезной в эксплуатации.
Типовые причины:
- переобучение — модель подстраивается под шум и детали обучающих данных;
- слишком много признаков — особенно если часть из них случайно коррелирует с целевой переменной;
- утечка данных — в модель попадают признаки, которые фактически содержат информацию из будущего или напрямую связаны с результатом;
- оценка только на обучающей выборке — показатель выглядит впечатляюще, но на новых данных резко падает.
Для операционных команд это означает одно: высокий R-квадрат без проверки на реальных сценариях не должен быть основанием для внедрения модели.
Низкое значение у полезной модели
Есть и обратная ситуация. Модель может иметь скромный R², но приносить бизнес-ценность.
Например:
- помогает ранжировать клиентов по вероятности роста чека;
- улавливает направление влияния цены на спрос;
- обнаруживает ключевые факторы затрат;
- даёт стабильный сигнал для планирования даже при высоком уровне шума.
В реальной практике полезность модели определяется не только глубиной объяснения вариации, но и тем, помогает ли она принимать лучшие решения.
Почему R-квадрат не показывает причинно-следственную связь
Это принципиальный момент. R² показывает, насколько хорошо модель объясняет вариацию, но не доказывает, что один фактор вызывает другой.
Например, если рост рекламных расходов связан с ростом продаж, высокий R² не доказывает причинность. Возможны:
- сезонные эффекты;
- скрытые факторы;
- обратная зависимость;
- случайное совпадение;
- влияние третьей переменной.
Для доказательства причинно-следственной связи нужны другие подходы: экспериментальный дизайн, A/B-тесты, квазиэксперименты, доменная экспертиза и проверка гипотез.
Какие ограничения и альтернативы важно знать
Скорректированный R-квадрат
Обычный R² почти всегда растёт или не снижается при добавлении новых признаков. Это создаёт ложный стимул усложнять модель.
Скорректированный R-квадрат нужен, чтобы учесть число переменных и “оштрафовать” модель за бесполезное усложнение. Он особенно полезен, когда:
- вы тестируете несколько регрессионных спецификаций;
- в модели много факторов;
- есть риск добавить шумовые признаки ради формального роста R².
Если обычный R² вырос, а скорректированный — нет, это сигнал, что новый признак может не приносить реальной пользы.
RMSE, MAE и другие метрики
Одна метрика почти никогда не даёт полной картины. Поэтому зрелая аналитическая практика предполагает совместную оценку нескольких показателей.
Почему это важно:
- R² показывает долю объяснённой вариации;
- RMSE показывает чувствительность к крупным ошибкам;
- MAE даёт более прямое понимание среднего масштаба промаха;
- MAPE может быть полезен, если нужен относительный процент ошибки, хотя его нужно аккуратно применять при малых значениях цели.
Для руководителя или владельца процесса ключевой вопрос обычно звучит не “какой у модели R²?”, а “насколько ошибается прогноз в бизнес-единицах и можно ли на него опираться в решениях?”
Что смотреть вместе с R-квадрат
Чтобы интерпретация была профессиональной, проверяйте не только сам показатель, но и контекст его получения.
Смотрите как минимум на следующее:
- ошибки на тестовой выборке — подтверждают, что модель не живёт только внутри обучающих данных;
- остатки — помогают увидеть систематические отклонения, нелинейность, выбросы и гетероскедастичность;
- стабильность модели — сохраняется ли качество по времени, сегментам и каналам;
- бизнес-логика — согласуются ли коэффициенты и выводы модели с предметной областью;
- сравнение с базовой моделью — действительно ли регрессия лучше простого прогноза.
Практические рекомендации по внедрению оценки качества модели
Ниже — 4 шага, которые я рекомендую использовать в корпоративной аналитике как минимальный стандарт.
-
Никогда не оценивайте модель только по R² на обучающей выборке.
Сразу разделяйте данные на train/test или используйте кросс-валидацию. -
Смотрите на R² в связке с RMSE и MAE.
Это даст одновременно и статистическую, и прикладную бизнес-картину. -
Проверяйте остатки и стабильность по сегментам.
Если модель хороша “в среднем”, но проваливается по ключевым регионам или категориям, её нельзя считать надёжной. -
Интерпретируйте показатель в контексте отрасли.
Для одних задач R² = 0,6 — отлично, для других этого недостаточно. -
Не подменяйте объяснение причинности описанием корреляции.
Если от модели зависят инвестиции, бюджет или операционные изменения, проводите дополнительную проверку гипотез.
FineBI: как упростить анализ R-квадрат и не ошибиться в оценке модели
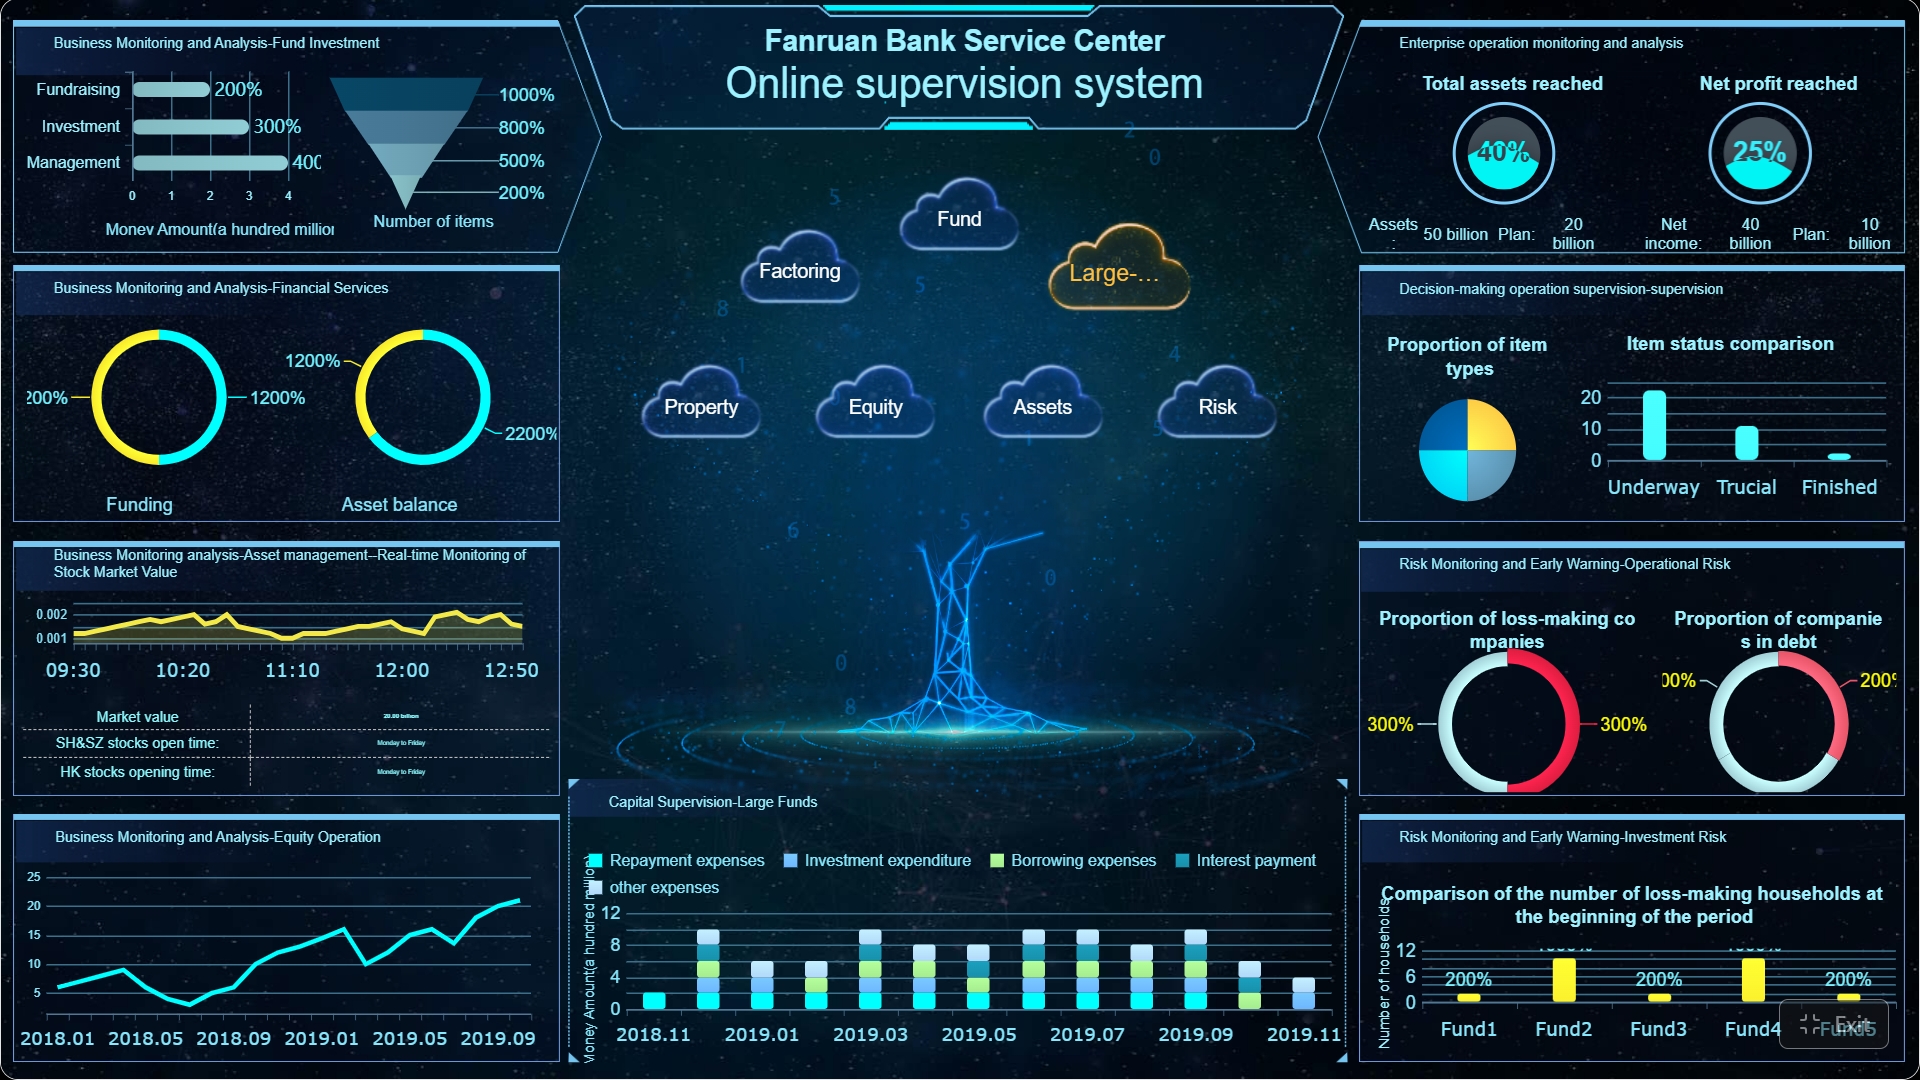
Если делать такой анализ вручную, процесс быстро становится сложным: нужно собирать данные из нескольких систем, считать метрики по разным срезам, отслеживать качество модели на обучении и тесте, визуализировать остатки, сравнивать версии модели и объяснять результаты бизнес-пользователям.
Построить всё это вручную сложно; используйте FineBI, чтобы задействовать готовые шаблоны и автоматизировать весь этот процесс.
FineBI помогает:
- собирать данные из разных источников в единую аналитическую среду;
- строить дашборды для оценки регрессионных моделей без разрозненных Excel-файлов;
- визуализировать R квадрат в регрессии, RMSE, MAE и ошибки по сегментам;
- контролировать качество моделей в динамике;
- предоставлять руководителям понятную и наглядную картину без перегрузки техническими деталями.
 templates: Fine Gallery](https://media.finebi.com/strapi/fine_gallery_8031d65fb3.png)
Получите готовые шаблоны дашбордов в Fine Gallery
Когда компании масштабируют аналитику, ценность даёт не просто сама метрика, а система мониторинга качества модели, встроенная в управленческий контур. Именно здесь BI-платформа превращает статистический показатель в рабочий инструмент принятия решений.
Краткие выводы
R квадрат в регрессии полезен, потому что быстро показывает, какую долю вариации целевой переменной объясняет модель. Это хороший старт для оценки качества, особенно когда нужно быстро понять, есть ли у модели объясняющая сила.
На него можно опираться, если:
- сравниваются сопоставимые модели;
- есть проверка на тестовых данных;
- метрика рассматривается вместе с ошибками и остатками;
- выводы согласуются с логикой предметной области.
Но R² может ввести в заблуждение, если:
- модель переобучена;
- добавлено слишком много признаков;
- анализ ведётся только на обучающей выборке;
- показатель трактуется как доказательство причинности или практической полезности.
Итог простой: не используйте R-квадрат в одиночку. Рассматривайте его как важную, но не единственную часть системы оценки модели.
FAQs
R квадрат показывает, какую долю разброса целевой переменной объясняет модель с помощью выбранных факторов. Чем выше значение, тем лучше модель описывает имеющиеся данные, но это не всегда означает хороший прогноз на новых данных.